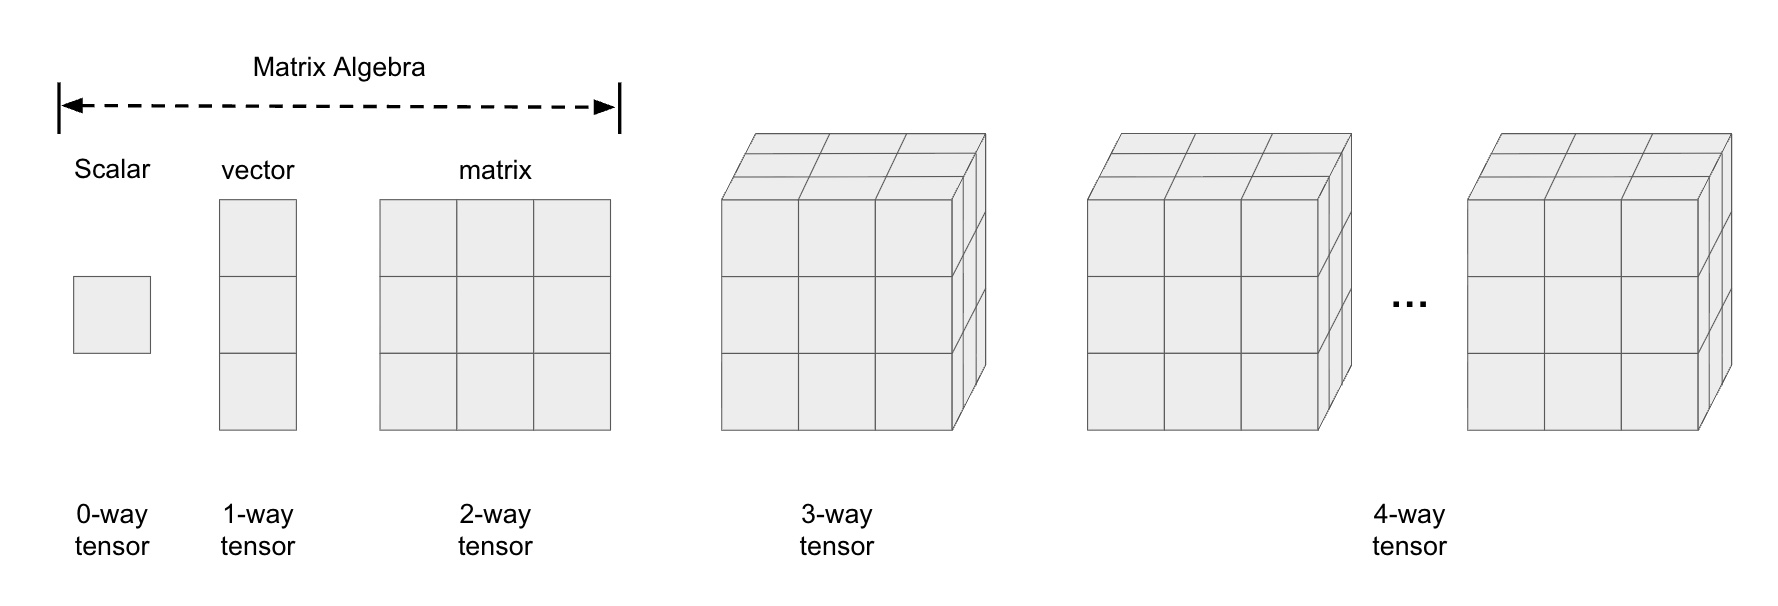
2026/09 5

딥러닝 5일차

-모델의 복잡도와 과적합 -모델링의 목적 : 학습용 데이터에 있는 패턴으로 그 외 데이터(모집단 전체)를 적절히 예측 - 모델의 복잡도 - 너무 단순한 모델 : train, val 성능이 떨어짐 - 적절히 복잡한 모델 : 적절한 예측력 - 너무 복잡한 모델 : train 성능은 높고, val 성능이 떨어짐 - 복잡한 모델이 되는 경우 => 선형, 로지스틱 : 변수의 수, DecisionTree : 트리크기(detph), KNN : K 값이 작을수록, XGB : 트리갯수 - 딥러닝의 복잡도 : hidden layer 수가 많을수록, node 수가 많을수록, epochs 가 많을수록 복잡해짐 - 딥러닝 모델의 복잡도 혹은 규모와 관련된 수 : 파라미터(가중치) 수 ..
카테고리 없음 2026.09.11

딥러닝 4일차

구분세부항목Regression2-ClassMulti-Class전처리y필요시 스케일링(→ y의 값이 클 때)0, 10, 1, 2, 3, ・・・Hiddem LayerActivationReLUReLUReLUOutput LayerActivationXSigmoidSoftmax(오차함수에 포함)Node 수11Class 수CompileoptimizerAdamAdamAdamlossnn.MSELossnn.BCELossnn.CrossEntropyLoss후처리predX0, 1로 변환(np.where).softmax().argmax() - Class 방식 모델 설계 - 클래스란? - 객체지향 프로그램의 핵심 개념 - 데이터(속성)와 기능(메서드 method)을 하나로 묶어 코드를 효율적으로 관리 ..

카테고리 없음 2026.09.10

딥러닝 3일차

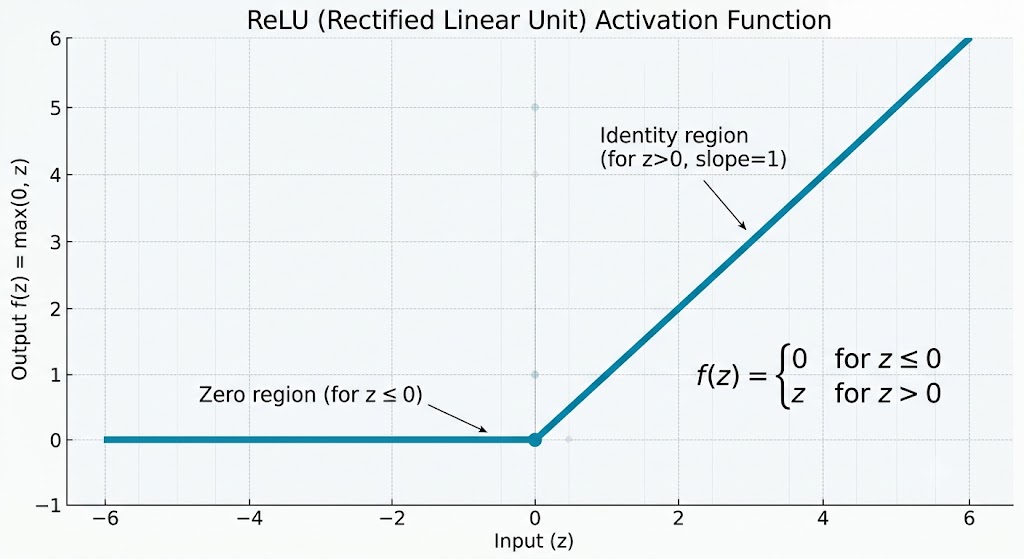
- ReLU - max(0, x) ~ 이 의미는 x가 0보다 크면 x를 선택하고, 0보다 작으면 0으로 선택함. - 그래프 모양 - 이진 분류 모델 구조 - 함수 (Function) : 입력값(x)을 넣으면 출력값(y)을 준다. (변환) - 이진 분류의 출력층 : 출력층의 결과를 0과 1로 변환해주는 함수가 필요 - 활성 함수 : 시그모이드 (Sigmoid) -> 이진 분류는 출력층에 시그모이드를 붙여줘야 하는구나~ * np.where( 조건문, True일 때 값, False일 때 값) - 분류 모델 평가 : Confusion Matrix - 일반적으로 이진 분류일 때, ✔︎ 우리의 관심사 = 1, 양성 Po..

카테고리 없음 2026.09.09

딥러닝 2일차

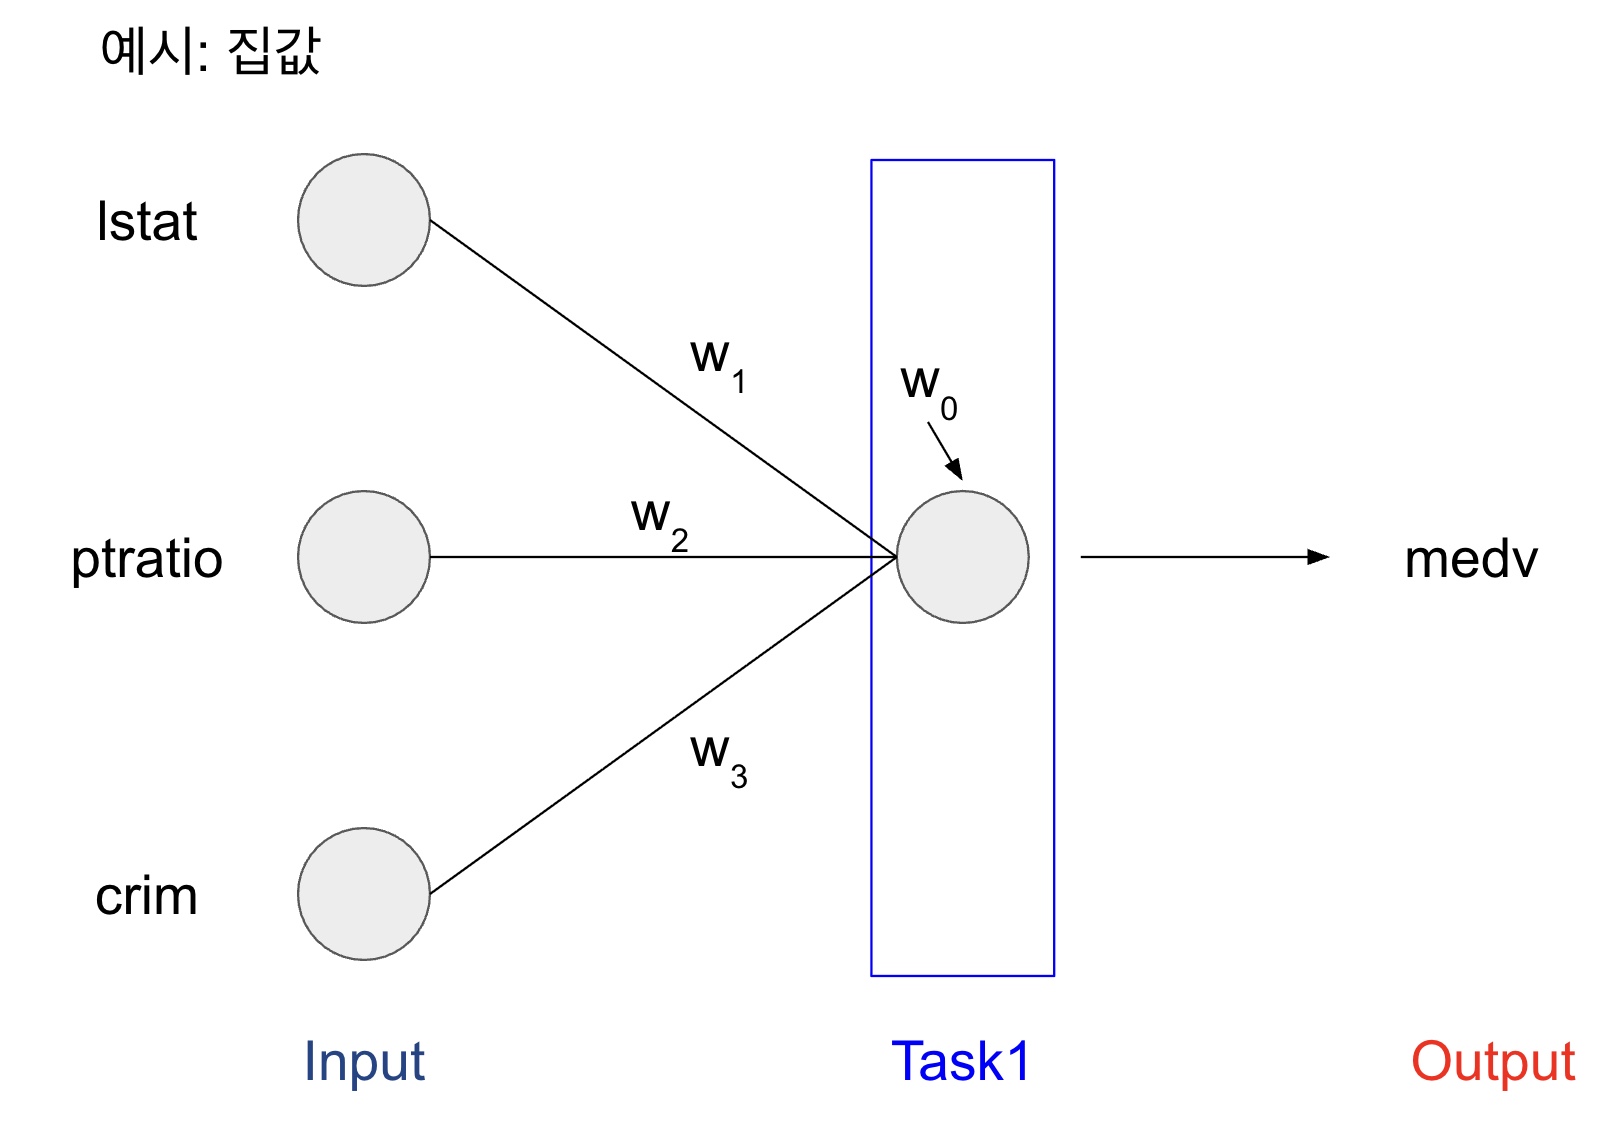
- 딥러닝 구조medv = w1・lstat + w2・ptratio + w3・crim + w0 - Input과 Output Layer 사이는 Hidden Layer (은닉층)model1 = nn.Sequential( nn.Linear(n_feature, 1) ) # n_feature는 input, 1은 output(노드가 1개인 층이구나~) - Loss function (회귀모델 --> MSE) - 다양한 이름 : 오차함수, 손실함수, 목적함수 (Objective Function)loss_fn = nn.MSELoss()optimizer = Adam(model1.parameters(), lr=0.1)# model1.parameters() 는 업데이트 할 파라..

카테고리 없음 2026.09.08