전체 Process (CRISP-DM) - Data / AI 기반 비즈니스 문제해결 방법론
1. Business Understanding - 비즈니스 문제 정의
- 데이터 분석 방향, 목표
- 초기 가설 수립 : x(feature) ---> y(target)
(x와 y를 합쳐서 '정보' 라고 함)
2. Data Understanding - 원본 식별(정보는 어디에?)
- 분석을 위한 구조 만들기
- 데이터 분석 EDA &CDA
3. Data Preparation - 모델링을 위한 데이터 구조 만들기
1) 모든 셀은 값이 있어야 한다. (결측값 조치)
2) 모든 값은 숫자여야 한다. (원-핫 인코딩 같은 작업 필요)
3) (필요시) 숫자의 범위가 일치 (스케일링, 정규화)
4. Modeling - 기본 알고리즘 4가지 : Linear Regression, Logistic Regression, Decision Tree, KNN
- 모델 만들기
- 검증하기
5. Evaluation - 기술적 관점 평가
- 비즈니스 관점 평가
6. Deployment - 모델 관리
- AI 서비스 구축
시작 : 무엇이 문제인가? ----------------------------> 끝 : 문제가 해결이 되었는가?
- 모델이란? 데이터로부터 패턴을 찾아, 수학식으로 정리해놓은 것.
- 모델링이란? 가능한한 오차가 적은 모델을 만드는 과정
- 딥러닝 코드 구조
1. 데이터 전처리
1) 데이터 전처리-1 : NaN 조치, 가변수화, 스케일링, 데이터 분할(머신러닝과 동일)
2) 데이터 전처리-2 : 텐서로 변환, Data Loader(train set)
2. 모델링 : 모델설계, Loss, Optimizer, 학습, 학습 곡선 검토, 예측 및 검증 평가
- 딥러닝을 위한 데이터 준비
1. Tensor
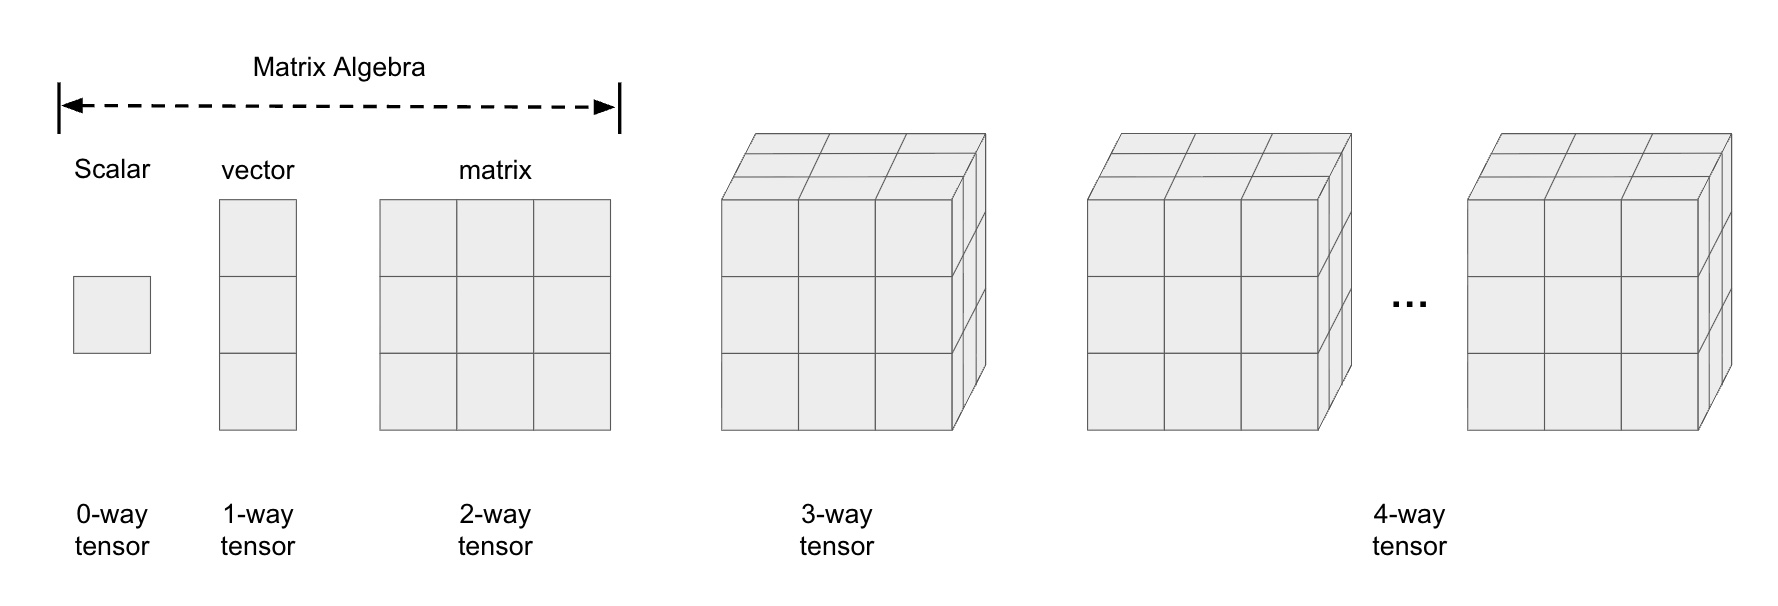
* shape이 (10, 3, 3) 은 무슨 뜻일까? 3x3 데이터가 10건 있다!
2. Data Loader
- PyTorch 모델링을 위해서 필요한 자료형
- Tensor : 텐서로 변환된 X와 y를 이용해서 학습 가능
- Data Loader : 텐서 데이터셋을 미니 배치 단위로 순차적으로 뽑아 학습에 사용하도록 제공
* Numpy Array → Tensor → Tensor Dataset → Data Loader
- 학습의 결과물은 가중치!!
- 학습이란? 오차 값을 최소화하는 가중치 값을 찾는다는 의미.
- Feed Forward : 정방향의 학습 단계
-back propagation : 오차를 계산한 뒤, 가중치를 줄이거나 조절하기 위해 출력층에서 입력층 방향으로 거슬러 올라가는 과정