< 복습 >
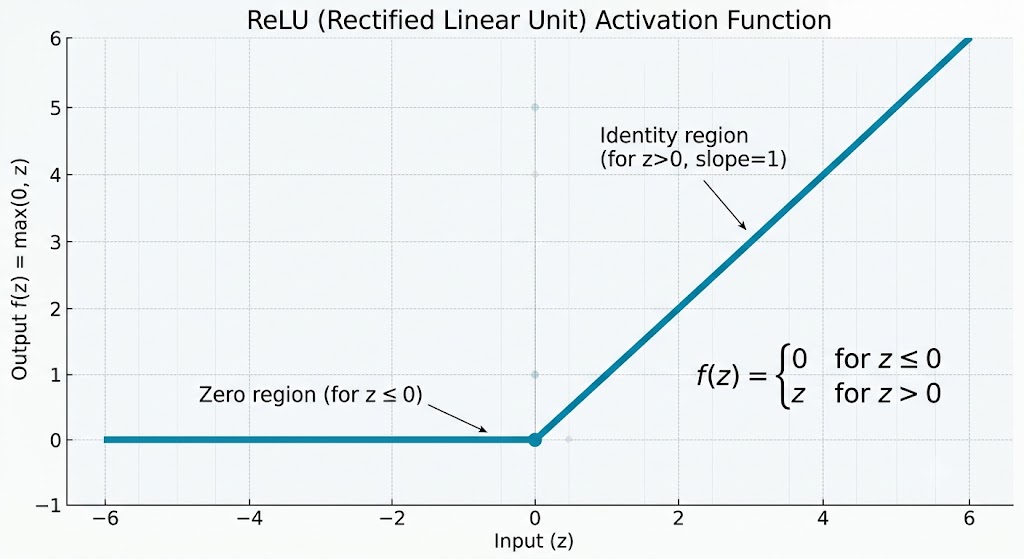
- ReLU
- max(0, x) ~ 이 의미는 x가 0보다 크면 x를 선택하고, 0보다 작으면 0으로 선택함.
- 그래프 모양
< 분류 모델링 1 >
- 이진 분류 모델 구조
- 함수 (Function) : 입력값(x)을 넣으면 출력값(y)을 준다. (변환)
- 이진 분류의 출력층 : 출력층의 결과를 0과 1로 변환해주는 함수가 필요
- 활성 함수 : 시그모이드 (Sigmoid) -> 이진 분류는 출력층에 시그모이드를 붙여줘야 하는구나~
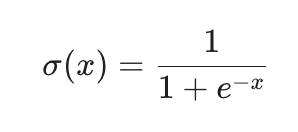
* np.where( 조건문, True일 때 값, False일 때 값)
- 분류 모델 평가 : Confusion Matrix
- 일반적으로 이진 분류일 때,
✔︎ 우리의 관심사 = 1, 양성 Positive
✔︎ 그 외 = 0, 음성 Negative
def make_DataSet(x_train, x_val, y_train, y_val, batch_size=32)

	# 데이터 텐서로 변환
    x_train_tensor = torch.tensor(x_train, dtype=torch.float32)
    y_train_tensor = torch.tensor(y_train.values, dtype=torch.float32).view(-1, 1)
    x_val_tensor = torch.tensor(x_val, dtype=torch.float32)
    y_val_tensor = torch.tensor(y_val.values, dtype=torch.float32).view(-1, 1)

    # TensorDataset 생성 : 텐서 데이터셋으로 합치기
    train_dataset = TensorDataset(x_train_tensor, y_train_tensor)

    # DataLoader 생성
    train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle = True)

    return train_loader, x_val_tensor, y_val_tensor

# x_train과 x_val은 Scaler 적용 후 Numpy Array  /  y_train과 y_val은 Pandas Series
# y_train.values 와 y_val.values 는 왜 values 를 붙이는 걸까? Series -> Array로 변환
# .view(-1, 1)의 의미는 N행, 1열 형태로 변환한다는 뜻.
# -1(자동 계산): 이 차원의 크기는 전체 요소 개수(N)와 다른 차원의 크기를 고려해서 알아서 자동으로 계산해줘
# 1(고정 크기): 열(Column)의 개수를 1개로 고정
- 손실 함수 : BCELoss / y = -log x
✔︎ y = 1인 경우 오차를 다음과 같이 변환
- 예측값(ŷ)이 1에 가까울수록 → 오차는 0에 가까워지도록
- 예측값(ŷ)이 0에 가까울수록 → 오차는 ∞에 가까워지도록
✔︎ y = 0인 경우 오차를 다음과 같이 변환
- 예측값(ŷ)이 0에 가까울수록 → 오차는 0에 가까워지도록
- 예측값(ŷ)이 1에 가까울수록 → 오차는 ∞에 가까워지도록
✔︎ 이 오차들의 평균
- Binary Cross Entropy
- PyTorch 제공 함수 : nn.BCELoss
< 분류 모델링 2 >
- 다중 분류 모델 구조
- Node 수 : 다중 분류 모델에서 Output Layer의 node 수는 y의 범주 수(클래스의 수)와 같습니다.
- Softmax : 각 class 별(Output Node)로 예측한 값을, 하나의 확률 값으로 변환.
➣ 손실함수 내부에 Softmax 연산이 들어있어서 출력층에 활성화 함수를 안쓴다!!
요약하자면...
| 손실함수 | y.shape | pred.shape | |
| 회귀 | MSELoss | (batch_size, 1) 예) (32, 1) |
(batch_size, 1) |
| 이진 | BCELoss | (batch_size, 1) 예) (32, 1) |
(batch_size, 1) |
| 다중 | CrossEntropyLoss | (batch_size, ) 예) [32] |
(batch_size, n_Class) |