- 딥러닝 구조
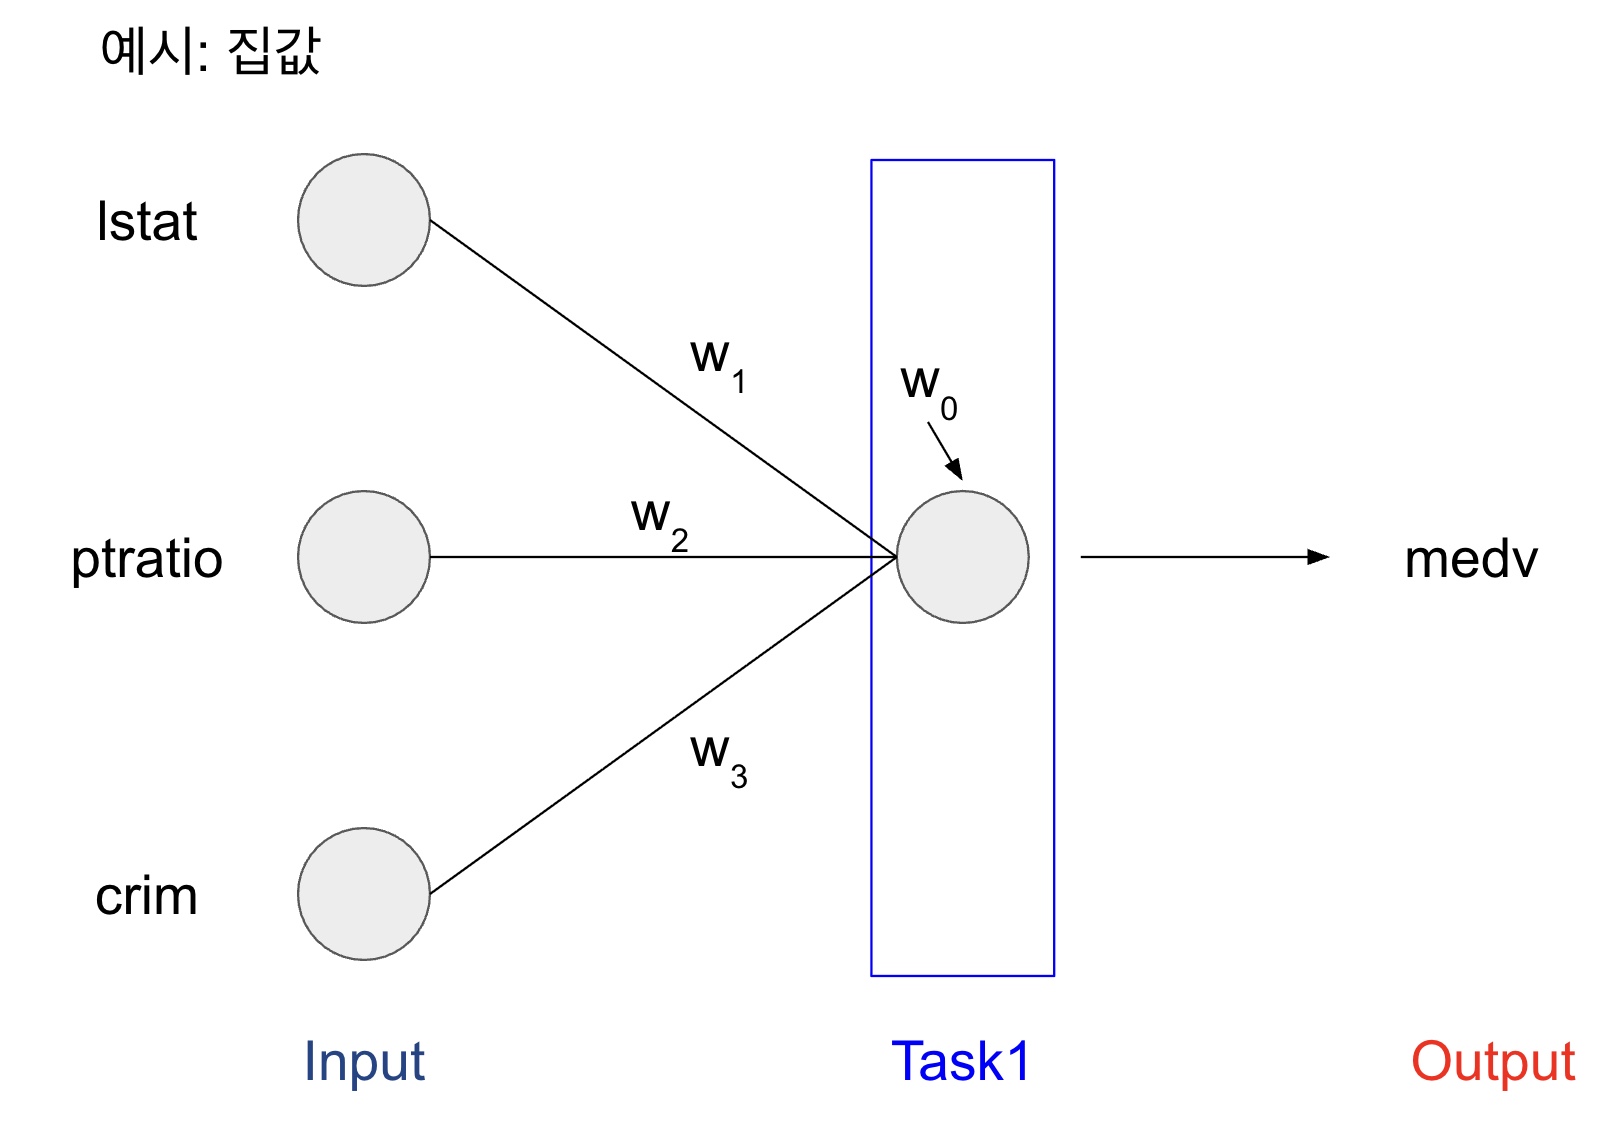
medv = w1・lstat + w2・ptratio + w3・crim + w0
- Input과 Output Layer 사이는 Hidden Layer (은닉층)
model1 = nn.Sequential(
			nn.Linear(n_feature, 1)
            )

# n_feature는 input, 1은 output(노드가 1개인 층이구나~)
- Loss function (회귀모델 --> MSE)
- 다양한 이름 : 오차함수, 손실함수, 목적함수 (Objective Function)
loss_fn = nn.MSELoss()
optimizer = Adam(model1.parameters(), lr=0.1)

# model1.parameters() 는 업데이트 할  파라미터, lr=0.1 은 업데이트 할 비율
- Optimizer
- 오차를 최소화 하도록 가중치를 업데이트 하는 역할
- Adam : 최근 딥러닝에서 가장 성능이 좋은 Optimizer로 평가됨
- learning rate : 업데이트할 비율, 기울기에 곱해지는 조정 비율
- 학습 곡선
- 모델 학습이 잘 되었는지 파악하기 위한 그래프 (정답은 아니지만 경향을 파악하는데 유용)
- 각 Epoch 마다 train error와 val error가 어떻게 줄어드는지 확인
- 바람직한 곡선
1) 초기 epoch 에서는 오차가 크게 줄고
2) 오차 하락이 꺾이면서
3) 점차 완만해짐
그러나 학습 곡선의 모양새는 다양함
- 은닉층 (Hidden Layer)
n_feature = x.shape[1]

# 모델 구조 설계
model2 = nn.Sequential(
			nn.Linear(n_feature, 2),
            nn.ReLU(),	# 활성화 함수 / Hidden Layer 뒤에 붙는다.
            nn.Linear(2, 1),
            ).to(device)
** fully Connected Layer 또는 Dense Layer 는 빽빽하게 모두 연결되어 있는 것을 뜻하고,
Locally Connected Layer 는 부분적으로만 노드에 연결되어 있는 것을 말함.
- 활성화 함수 (선형 함수를 비선형 함수로 변환해주는 함수)
- Sigmoid, tanh, ReLU
< 요약 >
► 딥러닝 전처리
- NaN 조치, 가변수화, 스케일링, dataloader 준비
►Layer
- Layer에는 input 과 output 을 지정
- Output 수가 Layer 의 node 수
- Output layer 의 node 수 : 1 (회귀 모델일 때!!)
- Activation Function
- Hidden layer 에 필요 : 비선형 모델로 만들려고 -> hidden layer 를 여러 층 쌓아서 성능을 높이려고.
- 회귀 모델링에서 Output Layer 에는 활성화 함수 필요하지 않음!