< SVM >
- SVM의 출발점 : '데이터들을 선형으로 나눌 때, 수 많은 선 중에 가장 최적의 선은 무엇이고, 가장 최적으로 설명하고 논리적으로 나눌 수 있을까?'에서 시작됨!
- 분류 문제의 핵심 : 최적의 경계는 무엇인가? : Support Vector(가장 인접한 데이터) 사이의 거리를 최대로 넓게 하는(마진,Margin) 최적의 선(Hyperplane)을 찾는 알고리즘이 SVM !!
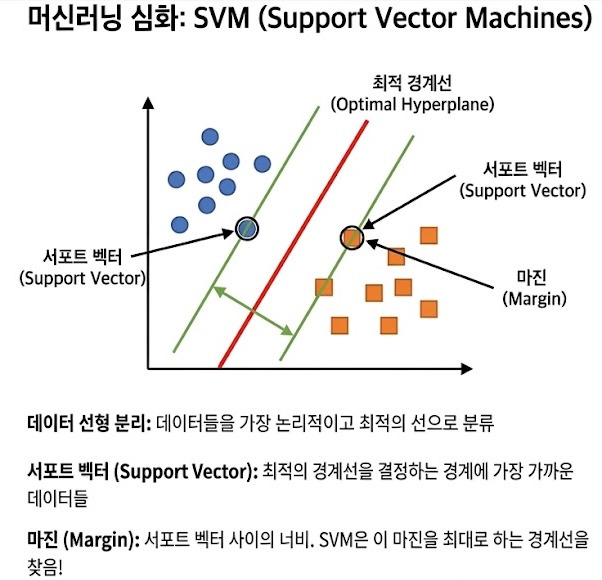
- SVC : (분류) 분류를 잘 해야하기 때문에 마진을 최대로 함. -> 불순도 발생 확률 줄임. (가장 인접해 있는 데이터가 support vector)
- SVR : (회귀) 마진이 최소가 되어야 함. (거리(hyperplane)가 가까워야 오차가 줄어든다는 뜻임, 데이터 외곽에 있는 데이터가 support vector)
- Soft Margin
- 문제점 : 완벽한 선형 분리가 불가능한 경우가 많음.
- 해결책 : Soft Margin
- 하이퍼 파라미터 C (Cost) : 오분류에 대한 비용(패털티)을 조절하는 값으로, 마진과 반비례 관계
- C 값이 커지면 마진은 좁아짐. 오분류를 최소화(Hard Margin, SVR)
- C 값이 작아지면 마진은 커짐. 오분류 허용(Soft Margin, SVC)
- SVM을 적용하려는데, 비선형 데이터라면...? -> 선형 분리는 불가능하니까 3차원으로 projection 시켜서 2차원 hyperplane으로 나눈다!
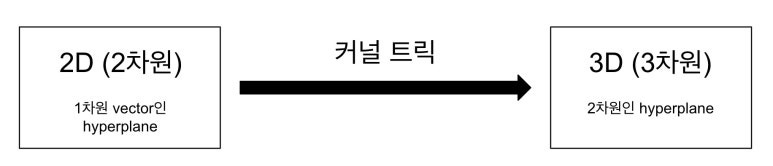
- 커널함수 (총 4개 중 2개 기억하자)
- Linear kernel
- RBF kernel (가장 성능이 좋은 기본 커널)
< 앙상블 (Ensemble) >
( SVM까지는 단일모델이었음. 앙상블 모델은 다수의 모델을 합친 것 -> 성능은 좋지만 복잡해짐. )
- 모델 성능의 한계를 넘어서 ; 앙상블 학습의 두 가지 핵심 전략 : 편향-분산 트레이드오프를 극복하는 배깅(Bagging)과 부스팅(Boosting) / 스태킹(Stacking)도 있음.
-
- 배깅과 부스팅은 동종 모델 간의 결합(homogeneous ensemble)
- 스태킹은 이종 모델 간의 결합 (heterogeneous ensemble)
-
- 편향-분산 트레이드오프 관계란 무엇인가?
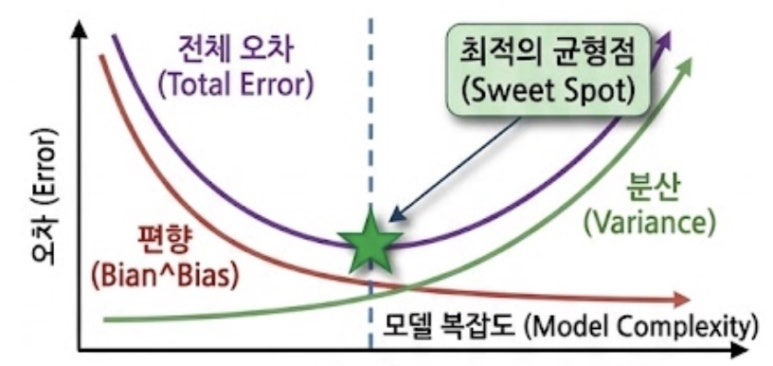
- 편향(Bias) : 모델이 너무 단순해서 데이터의 패턴을 제대로 학습하지 못한 정도 (Underfitting, 과소적합 원인), 중심과의 거리.
- 분산(Variance) : 모델이 너무 복잡해서 노이즈까지 과하게 학습하고 데이터 변화에 민감한 정도 (Overfitting, 과적합 원인), 흩어짐의 정도.
- 편향-분산 트레이드오프 관계란 무엇인가?
-
- 트레이드오프 관계의 핵심
- 이상적인 목표는 'Low Bias + Low Variance'
- 하지만 실제로는 하나를 줄이면 다른 하나가 늘어나는 상충 관계(Trade-off)임.
- high bias , low variance : 중심과의 거리는 멀지만, 흩어진 정도가 낮아 모여 있음.
- low bias, high variance : 중심과의 거리는 가깝지만, 흩어진 정도가 높음.
- high bias, high variance : 최악의 상황, 중심과 거리도 멀고, 흩어진 정도도 높음. -> 그럼 우리는 1번과 2번으로 선택! ( sweet spot 근처 범위 내에서 모델에 따라 움직임)
- 트레이드오프 관계의 핵심
-
-
- Sweet Spot : bias와 variance가 조화롭게 가장 낮은 최적의 상태.
-
- 앙상블 학습은 '집단 지성(Collective Intelligence)'을 활용한 예측 성능 향상 전략.
- 주요 전략 분류
- 병렬(Parallel) 방식 : 배깅(Bagging), 학습 속도는 더 빠름.
- 순차(Sequential)방식 : 부스팅(Booting) : 반복학습 같은 형태. '오답노트' 쓰면서 점차적으로 성능을 향상시키는 방식.
- 주요 전략 분류
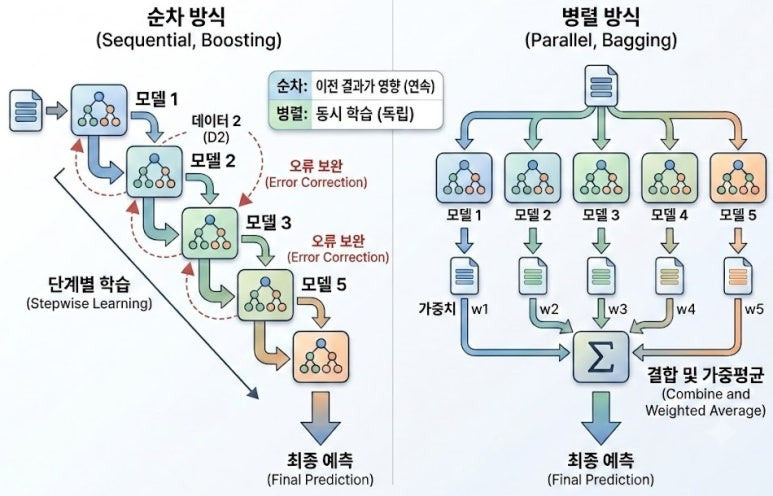
- 배깅(Bagging)
- Bagging = Bootstrap aggregating
- Mechanism
- Bootstrap : 중복을 허용하여(복원추출) 여러 개의 샘플 데이터셋(subset) 생성. (피처도 행도 랜덤하게 뽑음) -> 각기 다른 모델들이(weak learnmers,estimators) 학습한 내용을 예측하게 함. 예) K-Fold는 비복원 추출, 로또도 비복원 추출 -> 뽑은 숫자의 공을 넣지 않고 추출해서 비복원 추출 : 중복 허용 x, 확률이 달라짐.
-
-
- Aggregating(집계)
- 분류 : 다수결 투표에 따라 최종 결론을 내림.
- 회귀 : 예측값의 평균으로 최종 예측 결정.
- Aggregating(집계)
-
-
- 가장 대표적인 배깅 : 랜덤 포레스트(Random Forest), Extra Trees(랜덤 포레스트를 조금 변형한 형태) : 배깅이라고 하긴 약간 애매함. ( -> Bootstrap 은 하지 않지만 Aggregating 은 함. )
- 부스팅(Boosting) : 이전 모델의 실수로부터 학습하여 편향을 줄이다.
- 가중치를 활용하여 약한 학습기(Weak Learner)를 순차적으로 결합. 점진적으로 성능을 개선하여 강한 학습기(Strong Learner)를 만드는 방법. (오차를 학습해서 다음에 틀리지 않도록 학습하는 방법)
-
- 부스팅 알고리즘의 진화 : AdaBoost에서 Gradient Boosting까지
- AdaBoost : (처음 나온 부스팅) 가중치를 높여서 다음 모델이 틀리지 않도록 함.
- Gradient Boosting
- Gradient Descent : Weight와 손실함수의 관계를 이용하여 최적의 weight를 찾는 과정. 특정 지점 w에서 기울기가 가장 가파르게 하강하는 곳을 따라 learning rate 만큼 이동하면서 손실값 최소 지점으로 이동해가면서 최적의 weight를 찾는 알고리즘.
- 부스팅 알고리즘의 진화 : AdaBoost에서 Gradient Boosting까지
-
-
- 최신 부스팅 알고리즘 : XGBoost, LightGBM, CatBoost
-
와.. 오늘이 제일 어려운 이론처럼 느껴짐. 이해 잘 안되지만..