< Feature Engneering >
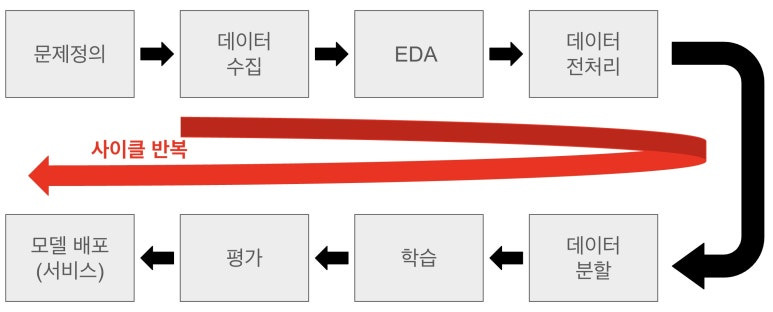
- 모델 구축 완료 후 모델을 배포하고, 서비스 운영하면 재학습 주기를 설정하고 데이터 수집하는 단계부터 사이클을 반복함.
- MLOpS : 재학습 주기를 알아서 진행해주는, 자동화하고 안정적으로 관리해주는 기술 및 실무 체계
* (용어 기억) 리팩토링 : 코드를 간결하고 깔끔하게 정리해놓은 소스코드 MLOps 옵션을 이용해서 자동화하는데, 여기에 소스 코드 등록!
- 피처 엔지니어링이란? 데이터에 숨겨진 의미를 파악
- 피처 선택(Feature Selection) : 모델 성능에 기여할 유용한 피처만 선택하고 불필요한 피처는 제거. -> 과적합 방지 및 모델 단순화에 기여
- 피처 생성(Feature Creation) : 기존 피처들을 결합, 변환하여 새로운 의미를 가진 변수 생성. -> 파생 변수 추가, 다중공선성 주의하기
- 피처 변환(Feature Transformation) : 기존 피처를 다른 형식이나 스케일로 변환. -> 로그변환, 스케일링, 범주형 데이터 인코딩
기본 다지기 1) 숫자형 피처 처리(Scaling)
- 표준화(Standardization-Z-Score) '평균에서빼고표준편차로나눈다' : 평균을 0, 표준편차를 1로 조정
- 정규화(Min-Max Scaling)
import MinMaxScaler
a = MinMaxScaler
a.fit_transform()- 강건한 스케일링(Robust Scaling)
import RobustScaler
a = RobustScaler
a.fit_trasform()- 범주형 피처 처리(Encoding) : 문자열로 된 데이터를 숫자 데이터로 변환
- 레이블 인코딩
- 원-핫 인코딩 : 더미변수(dummy) >> get_dummies / 결과를 0과 1로 보려면 dtype = int (이 옵션으로 설정)
- 고급 피처 엔지니어링 기법 -> 딥러닝에서 자세히 배울 내용
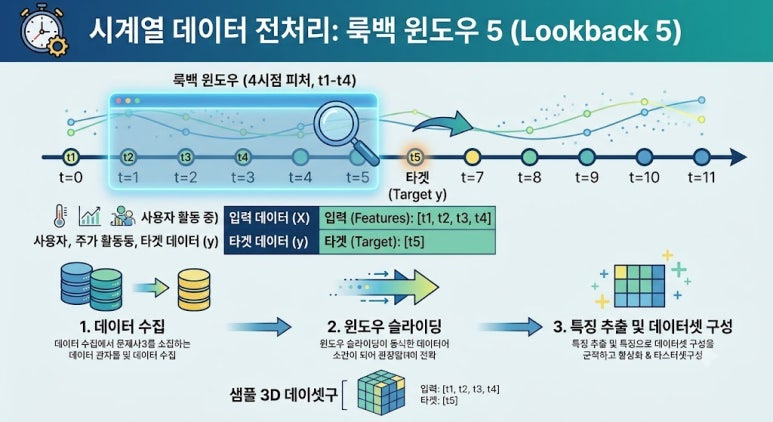
- 시계열 데이터 : 동일한 측정 대상에서 시간만 다른 데이터를 말함. 시계열 데이터 전처리 : 룩백, 윈도우 사이즈 지정해줘야 함.
-
- 비정형 데이터
- 신호 처리
- 자동화 기법
- 올바른 피처 선택하기
- 필터기법
- 래퍼기법 : 성능을 봐가면서 해당 피처를 넣을 것인가, 뺄 것인가 선택하는 방법 (머신러닝에서 주로 사용하는 방식)
- 내장기법 -> 주로 사용(Lasso, 트리기반 모델)
-
- 왜 Feature Selection을 해야하는가? 과적합 위험을 줄이고 계산 속도를 높이며 해석 가능성을 향상시키기 위해 (피처 수를 줄이는(모델 복잡성 감소) PCA 와 비슷한 듯 하면서 다른 개념)
-
- RFECV & RFE (CV = Cross Valisation)
-
-
- RFE : 피처를 제거할 때, 성능의 변화를 보면서 특성 중요도가 낮은 순서대로 지워나가는 방식
- RFECV : 성능의 변화를 측정(교차검증)해서 최적의 개수를 찾아내는 기능까지 더한 것. (RFE에 교차검증까지 추가된 것)
- 전진선택법 / 후진소거법 / Stepwise
-
<Pipeline>
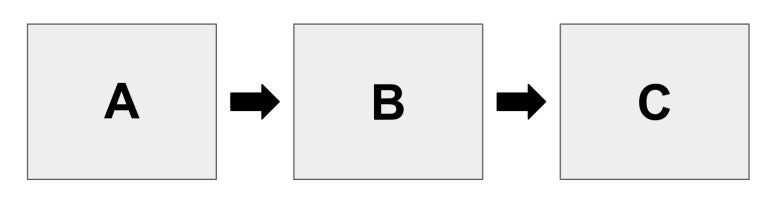
: A 과정에서 나온 결과를 B 입력값으로 받고, B 과정을 거쳐 나온 결과를 C 입력값으로 받는 이런 구조 -> '파이프라인 아키텍처' 라고 함.
- 교차 검증(Cross Validation) (데이터 건수가 많지 않더라도 검증 데이터로 활용할 수 있는 방법을 다루는 내용임.) : CV에는 다양한 기법이 있는데, 그 중 가장 많이 사용되는 기법!
- K-Fold 기법 (5-Fold, 3-Fold,....) * 5-Fold는 무슨 뜻인가? 5개로 training data를 나누겠다는 의미.
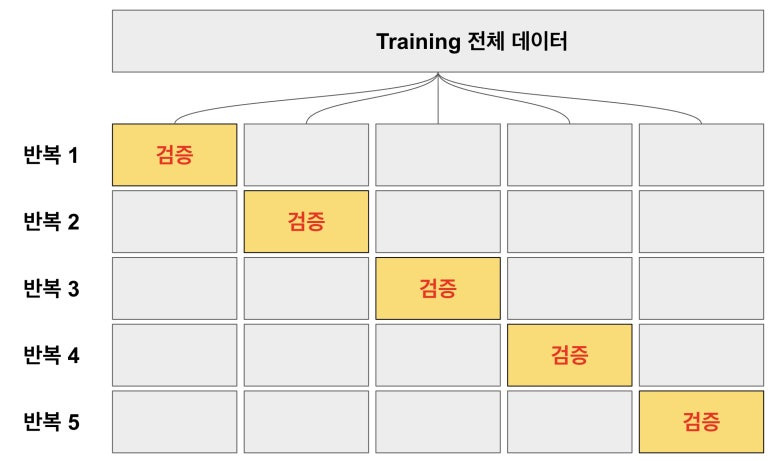
: K만큼 나누고, K만큼 반복하겠다는 의미! / Fold를 번갈아가면서 검증데이터로 쓰겠다 >> 성능이 좋아짐!
-> 4개는 training data, '검증'은 validation data
-
- Cross Validation 적용하는 함수 2가지
- cross_val_score -> 단일 평가지표에 대한 점수 배열(array)을 반환
- cross_calidate -> 'cross_val_score'의 확장된 버전, 다중 평가지표 동시 평가 가능!
- Cross Validation 적용하는 함수 2가지
-
- 불균형 데이터의 함정 : Stratified K-Fold
- training data 와 test data를 분할한 상태에서 training data를 또 나누는 건데, 특정 Fold에 치우칠 수 있음. -> 극복 방법 : Stratified K-Fold ('cross_val_score'은 기본적으로 장착(?)되어 있음.
- 불균형 데이터의 함정 : Stratified K-Fold
아직까진 심화과정이지만 강사님 설명 덕분에 잘 이해하는 중!!