어제 내용에 이어서 보충 내용!!
- KNN; 거리와 관련된 지표
- 유클리드 거리(Euclidean Distance) : 두 지점 사이의 최단 거리(피타고라스의 정리를 이용한 거리 측정)
- 맨해튼 거리(Manhattan Distance) : 좌표축을 따라 이동한 거리의 합
- 해밍 거리(Hamming Distance) : 같은 길이의 두 문자열/벡터에서 값이 다른 위치의 개수
- 민코프스키 거리(Minkowski Distance) : 유클리드와 맨해튼 거리를 일반화한 형태
<본격적으로 머신러닝 심화!!>
- 왜 차원을 축소하는가?
- 차원의 저주(Curse of Dimensionality) : 차원이 커지면 커질수록 학습 시간이 길어진다거나 복잡해질 수 있음.
- 다중공선성(Multicollinearity) : feature들끼리 상관관계가 높은 것.
- 계산 효율성 저하( = 학습 시간이 오래걸린 다는 의미)
- 해결 : PCA(주성분 분석 : 차원 축소 기법)
- 여러 개의 feature들이 있는데, 같은 특성이 있는 feature(2-3개)들을 모아서 새로운 feature를 생성.
2. 군집화(Clustering)
- K-Means : 가장 직관적이고 강력한 군집화 알고리즘
- 정의 : 데이터를 미리 정해진 K개의 군집(Cluster)으로 나누는 비지도 학습 알고리즘.
- 작동 원리
- 1단계 : 임의의 중심점을 정하기
- 2단계 : 가까운 중심점에 배정하기
- 3단계 : 중심점 다시 계산하기(해당 데이터들의 평균값을 중심점으로 둠)
- 4단계 : 중심점의 위치가 바뀌지 않을 때까지 2,3단계를 반복하기
-
- 기본 K-Means의 문제점
- 기존 K-Means는 첫 중심점 K개를 완전 무작위(Random)로 뽑기 때문에 중심점들이 서로 가까운 위치에 몰려서 선택될 위험이 크며, 이 경우 군집화 성능이 떨어지거나 계산 시간이 오래 걸림.
- 기본 K-Means의 문제점
-
- K-Means++의 해결책
" 첫 번째 중심점만 랜덤으로 뽑고, 그 다음 중심점부터는 기존 중심점들과 거리가 '멀수록' 선택될 확률을 높인다 "
< 군집화 심화 내용 >
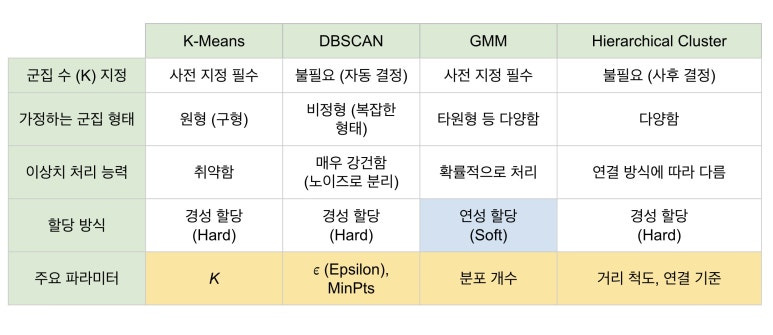
- 군집화 알고리즘
- 중심 기반 or 거리 기반 (K-Means)
- 밀도 기반 (Mean Shift, DBSCAN) : 데이터의 밀도에 따라 군집화, 커밀 밀도 추정(KDE) 기반
- 계층 기반 : 덴드로그램 형성
- 분포 기반 (GMM)
- GMM(Gaussian Mixture Model)
- 어떤 데이터가 가우시안 분포 ( 정규분포라고 이해하자) 들 중에 어느 곳에 해당하는지 확률을 계산해서 가장 높은 확률을 가진 군집에 할당하는 것.
📌 GMM 설명 보완 & 정제 포인트
- Hard Assignment vs Soft Assignment (연성 할당)
- K-Means / DBSCAN (Hard Assignment) : 데이터를 무조건 A 군집 혹은 B 군집처럼 하나의 군집에 딱 잘라 배정함.
- GMM(Soft Assignment) : "이 데이터는 A 분포일 확률이 80%, B 분포일 확률이 20%" 처럼 확률값 자체를 부여함.
- 그렇다면 왜 GMM에서는 하필 '가우시안(정규분포)'을 기준으로 데이터 분포를 가정할까? -> 그 수학적 근거가 되는 통계학의 핵심 이론이 바로 '중심극한정리(CLT)' 이다.
* CLT (Central Limit Theory, 중심 극한 정리) : " 모집단의 분포가 무엇이든 간에, 표본의 크기(n >= 30)가 충분히 크다면 표본평균들의 분포는 정규분포에 가까워진다 " / (쉽게 말해, 모집단이 어떤 분포를 가지든 상관없이 30개 이상의 데이터를 랜덤하게 뽑아 평균을 구하는 과정을 반복하면 그 평균값들은 정규분포를 따른다는 뜻)
- Mean Shift
- 커널 밀도 추정(KDE)
- 중요 파라미터(하이퍼 파라미터) : h (대역폭, bandwidth) - 설정값이 매우 중요함.
- h 가 너무 클 경우, 과소적합 경향 : 지나치게 적은 수의 군집 생성
- h 가 너무 작을 경우, 과적합 경향 : 지나치게 많은 수의 군집 생성
- estimate_bandwidth() 함수가 대략적인 대역폭 설정을 도와줌.
- DBSCAN
- 장점 : 비정형 형태의 군집화도 가능하다는 점
- 중요 파라미터(하이퍼 파라미터) : Epsilon ( eps, 𝜖 ), MinPts(min_samples)
- eps 가 너무 크면, 하나의 거대 클러스터로 연결될 수 있음.
- eps가 너무 작으면, 대부분의 점이 노이즈로 처리될 수 있음.
- MinPts가 너무 크면, 군집으로 인정받기 위한 기준이 까다로워지므로, 더 많은 데이터가 노이즈(이상치)로 분류됨.
- MinPts가 너무 작으면, 기준이 완화되어 노이즈가 줄어들고 작은 군집들이 많이 형성됨.
낯설고 너무 많은 개념이 한꺼번에 들어와서 과부화...
복습 만이 살 길 이다 ㅠㅠ