- 분류(Classification)
- 정의 : 데이터를 사전 정의된 여러 클래스(범주) 중 하나로 할당하는 지도학습 방법
- 목표 : 학습 데이터를 통해 패턴을 익혀, 새로운 데이터가 어떤 클래스에 속할 지 예측
- 주요구분
- 이진분류(Binary Classification) : 데이터를 2개의 클래스로 분류
- 다중분류(Multiclass Classification) : 데이터를 3개 이상의 클래스로 분류
- 이진 분류 심층 분석 : Unit step에서 Sigmoid 까지
- Sigmoid Function(시그모이드 함수) : 대표적인 활성화 함수로, 어떤 값을 입력하든지 0과 1 사이의 값으로 변환해주는 함수
* 활성화 함수(Actication Function)란?
인공 신경망에서 입력 신호의 총합을 출력 신호로 변환하여 모델에 비선형성을 부여하는 함수.
선형성을 가진 모델은 과소적합될 경우가 많기 때문에 비성형성으로 바꿔주는 것. (선형성 -> 비선형성)
- Logistic Regression(이진분류) -> Regression(회귀) 인데 어떻게 분류인가?
- 작동 방식은..
- 1단계 : 선형 회귀(Linear Regression)를 통해 제한 없는 실수값(점수)을 계산
- 2단계 : 시그모이드 함수에 통과시켜 0과 1 사이의 확률값으로 변환함. (우선 Regression(숫자 맞추기)하고 시그모이드 함수에 넣어 값으로 변환함.)
- 3단계 : 최종 분류를 진행함. 출력된 확률이 특정 기준값(Cut-off value, 보통 0.5) 이상이면 1(Positive), 미만이 0(Negative)으로 최종 판단함. (상황에 따라 Cut-off value 변경 가능, 0.5보다 크거나 작게..)
- 이진 분류 심층 분석 : 로지스틱 회귀와 손실 함수
- 로지스틱 회귀
- Sigmoid 함수를 출력층에 사용하여 이진 분류를 수행하는 선형 모델
- 선형 모델의 예측(Logit)을 sigmoid를 통해 0과 1 사이의 확률 값으로 변환
- 손실 함수 : 회귀 모델에서의 손실 함수와 분류 모델에서의 손실 함수는 다를 수 밖에 없음. (회귀 모델은 정답을 정확히 맞추긴 어렵고 얼마나 근접했는지를 평가하는 것이고, 분류 모델은 정답에 얼마나 근접했느냐가 아니라 얼마나 잘 맞추느냐를 평가하는 것이기 때문에 손실 함수도 평가지표도 다를 수 밖에 없음.)
- 로지스틱 회귀
- 성능 평가의 함정 : 정확도(Accuracy)의 한계
- 정확도(Accuracy) : 가장 직관적인 지표이지만, 데이터 불균형 상황에서 모델 성능을 심각하게 왜곡할 수 있음.
- 극복방법 : 혼돈 행렬(Confusion Matrix)
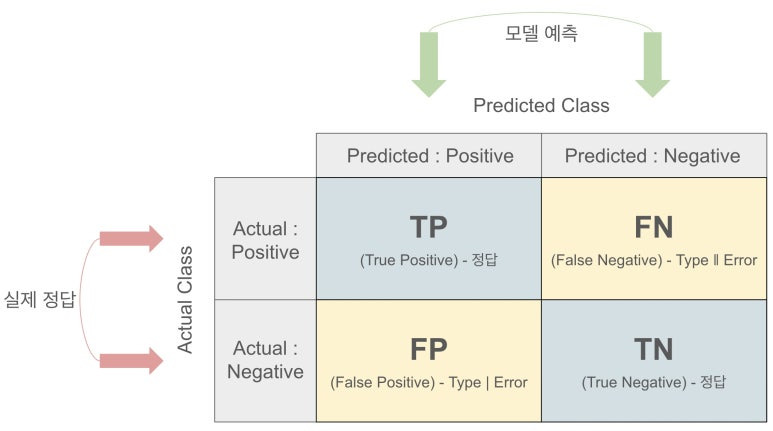
- T, F 의미 : T 는 모델이 맞췄다는 뜻이고 F는 모델이 틀렸다는 뜻.
- P, N 의미 : P는 Positive, N은 Negative
- TP : 모델이 P라고 했는데 맞췄음.
- FN : 모델이 N이라고 했는데 틀렸음.
- FP : 모델이 P라고 했는데 틀렸음.
- TN : 모델이 N이라고 했는데 맞췄음.
- Confusion Matrix를 통해 나올 수 있는 지표 : Precision, Recall, F1-Score / 출력될 때 형태 : ([[TN, FP], [FN, TP]])
- Precision(정밀도)
- 수식 : TP / (TP + FP)
- 정의 : 모델이 Positive(있음) 라고 예측한 것 중 진짜 Positive의 비율
- 관련 오류 : 오탐(FP)을 줄이는 지표
- 의미 : '모델이 있다'고 한 말 중에 진짜가 얼마나 되는가? -> 모델이 없는데 있다고 헛다리 짚으면(오탐이 많아지면) 정밀도가 떨어짐.
- Precision(정밀도)
-
- Recall(재현율)
- 수식 : TP / (TP + FN)
- 정의 : 실제 Positive(있음)인 것 중 모델이 Positive로 맞힌 비율
- 관련 오류 : 미탐(FN)을 줄이는 지표
- 의미 : 실제 있는 진짜들 중에 모델이 얼마나 빠뜨리지 않고 찾아냈는가? -> 모델이 있는데 없다고 놓쳐버리면(미탐이 많아지면) 재현율이 떨어짐.
- Recall(재현율)
-
- F1-Score(Precision 과 Recall의 평균)
- 수식 : (Precision x Recall) / (Precision + Recall)
- 의미 : Precision과 Recall이 얼마나 균형을 잘 잡고 있는가, 조화균형 -> 균형 잡힌 지표
- F1-Score(Precision 과 Recall의 평균)
"📌 [보충] 오탐과 미탐 개념 확실하게 잡기"
- 오탐 : 실제로는 대상이 아닌데(Negative) 대상이라고 잘못 탐지한 경우(Positive) 쉽게 말해, 없는데 있다고 한 것. (헛다리)
-
- 예시
- 암 진단 : 실제론 정상인인데 검사 결과 암으로 나온 경우
- 스팸 메일 : 중요한 정상 메일인데, 모델이 스팸 메일로 분류해 버린 경우
- 예시
-
- 문제점 : 오탐이 많아지면 불필요한 재검사 비용이 들거나, 알람에 대한 피로도(양치기 소년 효과)가 높아짐.
- 미탐 : 실제로 대상이 존재하는데(Positive) 탐지하지 못하고 놓친 경우(Negative) 쉽게 말해, 있는데 없다고 한 것. (놓침)
-
- 예시
- 암 진단 : 실제로 암 환자인데, 검사 결과 정상으로 나온 경우
- 스팸 메일 : 진짜 스팸 메일인데, 스팸 메일함에 들어가지 않고 일반 메일함으로 들어온 경우
- 침입 미탐지 : 해커가 침입했는데 보안 시스템이 '이상 없음'으로 판단한 경우
- 예시
-
- 문제점 : 미탐이 발생하면 위기 상황을 방치하게 되므로 치명적인 위험으로 이어지는 경우가 많음.
▶ 요약하자면, 오탐을 줄여서 모델의 예측을 신중하게 만드는 것이 정밀도(Precision) 이고, 미탐을 줄여서 진짜를 하나도 놓치지 않게
하는 것이 재현율(Recall)임.
- 실전 고급 기법 : 데이터 불균형 다루기(Imbalanced Dataset)
- 문제 : 소수 클래스(Minority Class) 데이터가 너무 적어 모델이 편향되게 학습됨.
- 해결 전략 : 데이터 리샘플링(Resampling)
- 언더샘플링(Under-sampling) : 다수의 클래스 데이터를 제거하여 비율 조정
- 오버샘플링(Over-sampling) : 소수 클래스 데이터를 증식하여 비율 조정(중복 데이터 있을 것)
- SMOTE(Synthetic Minority Over-sampling Technique) : 단순 복제가 아닌 소수 클래스 샘플과 비슷하게 합성하는 것. (중복 X)
- 다양한 분류 알고리즘
- 로지스틱 회귀 분류 모델 외 분류 모델 : 의사결정 트리, 서포트 벡터 머신(SVM), K-최근접 이웃(K-NN), 나이브 베이즈(Naive Bayes)
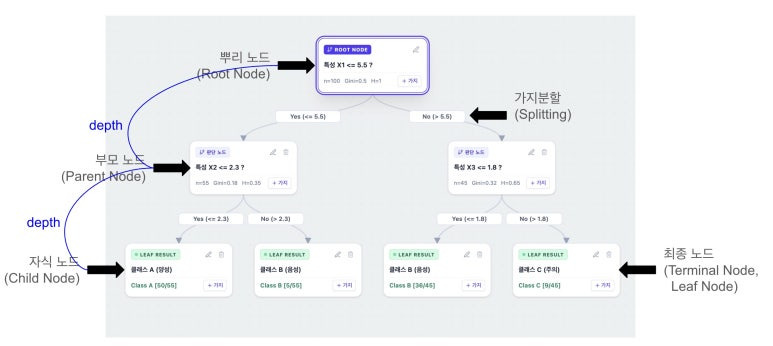
- 의사 결정 나무를 구성하는 핵심 요소들
- 불순도(Impurity) 감소
- 각 분기(split)의 목표는 자식 노드의 불순도를 최소화하는 것.
- 불순도 측정 지수 1. 지니 지수(Gini Index) 2. 엔트로피(Entropy) ; Cross-Entropy
- 각 분기(split)의 목표는 자식 노드의 불순도를 최소화하는 것.
- 사전 가지치기(Pre-Pruning) : 불필요한 가지 제거
- 왜 하는가? 복잡한 모델을 만들지 않으려고 (트리 계열에서 overfitting 방지 기법 중 하나)
- 하이퍼 파라미터 : max-depth(depth 제한)
- 하이퍼 파라미터 : min_samples_leaf
- 나이브 베이즈에서 베이즈란 무엇인가? (의미만 알고 가자)
- 베이즈 정리(Bayes' Theorem) : x 라는 사건(전제 사건) 이 발생했을 때, y 사건이 일어날 확률, 그 확률 계산은 P(Y|X) = (P(X|Y) x P(Y)) / P(X) -> 이 알고리즘으로 만든 모델이 나이브 베이즈
- 예시 : NLG -> 어떤 단어가 주어졌을 때, 그 다음에 올 특정 단어들이 나타날 확률을 계산하는 기준