< XGBoost >
- 핵심 원리 : Gradient Boosting 이전 모델의 예측 오류(Residual)를 학습하는 새로운 모델을 순차적으로 추가하여 성능을 개선하는 앙상블 개념
- 무엇이 XGBoost를 'eXtreme' 하게 만드는가? 기존 GBM의 한계를 극복하는 핵심 최적화 기술 탑재 => 정규화(L1, L2), 병렬처리(일부), 결손값 처리, 트리 프루닝(사전가지치기, 사후가지치기)
< LightGBM >
-
- 경량의 'Light' : 메모리를 적게 사용한다는 의미
- OOM(Out Of Memory) : 메모리 부족 현상
- 핵심 : 대용량 데이터셋을 위한 빠르고 효율적인 Gradient Boosting 프레임워크
- 차별점 : 기존 GBDT(Gradient Boosting Decision Tree)의 속도 및 메모리 한계 극복
- GOSS 와 EFB 를 통해 속도와 메모리 한계를 극복!
- 기존 GBDT의 병목 현상 : 최적의 분할 지점(Split Point)을 찾기 위해 모든 피처에 대해 모든 데이터 포인트를 스캔 -> 이 방식은 피처 개수와 데이터 크기에 비례하여 연산량 폭증
- 결과적으로 발생하는 문제 : 느린 학습 속도, 높은 메모리 사용량, 확정성 한계
- LightGBM의 두 가지 핵심 무기
- Gradient-based One-Side Sampling (GOSS) : 학습이 잘 진행되지 않은 데이터에 대해서는 집중을 하고(데이터를 100% 다 가져가고), 학습이 잘 진행된 데이터에 대해서는 랜덤하게 일부만 추출하여 데이터 양은 줄이면서도 분포는 유지함. => Gradient 가 큰 데이터(기울기가 큰 데이터)는 학습이 아직 되지 않은, 모델이 예측하기 어려워하는 '중요한' 데이터라는 뜻이고, Gradient 가 작은 데이터는 모델이 이미 잘 예측하는 '쉬운' 데이터라는 뜻.
-
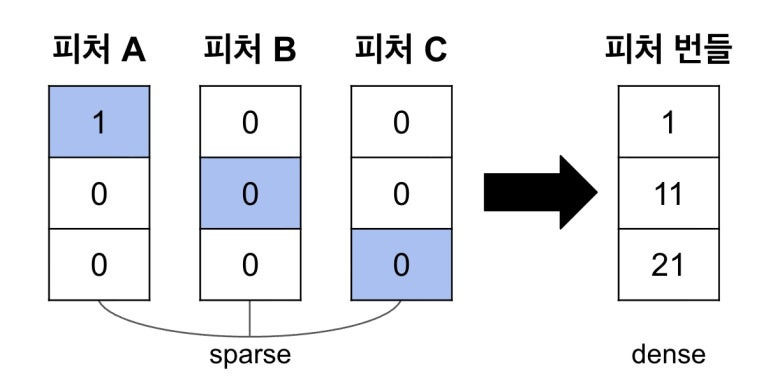
- Exclusive Feature Bundling (EFB) => '희소 피처' 압축하기 : One-Hot Encoding 과정에서 생긴 의미없는 dummy 변수를 압축하는 방식
< CatBoost >
: 범주형 피처가 많을 때, CatBoost가 성능이 좋을 수도 있음(확정은 아니고..)
- 기존 부스팅 라이브러리의 숨겨진 문제점
- XGBoost와 LightGBM은 강력한 성능으로 테이블 데이터(Structural data=Tabular data) 분석의 표준 -> 핵심 문제 : 예측 편향과 타겟 누수
- 타겟 누수(Target Leakage) - "시험 문제에 정답을 적어둔 꼴"
- 쉬운 비유 : 내일 치를 시험을 공부하는데, 문제집에 정답이 살짝 비쳐서 정답을 보면서 문제를 푸는 상황
- 개념 : 모델을 학습시킬 때, 원래라면 알 수 없어야 할 '미래의 정답 정보'가 학습 데이터에 슬쩍 흘러 들어가는 (Leak) 현상임.
- 문제점 : 범주형 변수를 변환할 때 정답 데이터를 직접 쓰면 발생함. 학습할 때는 정답을 보고 푸니 100점을 맞히지만, 실제 시험(실제 데이터)에서는 정답지가 없으므로 모델이 멘붕에 빠지게 됨.
- 예측 편향(Prediction Shift) - "실전에서 예상과 딴판이 되는 현상"
- 쉬운 비유 : 정답지를 보면 연습했을 때는 100점이 나왔는데, 실전 시험장에 가니 내실(실력)이 없어 점수가 엉망진창으로 빗나가는 상황임.
- 개념 : 타겟 누수 때문에 발생하며, '학습할 때 예상했던 정답의 분포'와 '실제 데이터에서 예측한 정답의 분포'가 서로 어긋나서 완전히 달라지는 현상을 말함.
- 문제점 : 이전 트리가 만든 오차(잔차)를 계산할 때 똑같은 데이터로 반복 계산하다 보니, 모델이 학습 데이터에만 과도하게 맞추어지는 과적합(Overfitting)에 빠지고 실전 성능이 뚝 떨어짐.
- Ordered TS 해결책
- 데이터를 무작위 순서로 나열한 뒤, 자신보다 순서상 '과거(이전)'에 있는 데이터들의 정답만 사용해서 힌트를 계산함. 즉, 현재 시점의 학습을 하는 데이터의 타겟은 묻어두고, 그 앞에 있는 타겟까지만 학습하게 해서 예측 편향을 해결!