< Random Forest >
- 여러(N개) 개의 Decision Tree(Weak Learner)들을 모아서 하나의 강력한 모델을 만드는 앙상블 학습 기법
- Core Principle 1 : Bagging(Bootstrap Aggregating) - 행 방향으로 랜덤하게 복원 추출
- Core Principle 2 : Random Feature Selection - 열 방향으로 랜덤하게 추출되는 것 -> 다양성 증대와 상관관계 감소(다중공선성 감소)
- 핵심 하이퍼 파라미터
- n_estimators : 생성할 트리 개수(몇 개의 트리를 만들어서 앙상블을 만들 것인가)
- criterion : 노드분할 품질 측정 기준(손실함수로 보자)
- 분류 : gini, entropy (불순도)
- 회귀 : squared_error(MSE 기반), absolute_error(MAE 기반)
- max_depth : 트리의 최대 깊이
- max_features : 각 노드에서 고려할 최대 특성의 수
- min_samples_split : 노드를 분할하기 위한 최소 샘플 수
- min_samples_leaf : 리프 노드가 되기 위한 최소 샘플 수
- random_state : 난수 시드 고정(동일한 결과를 얻기 위해 설정)
< Extra Trees >
-
- 'Extraemely, 극도로', 랜덤을 극도로 했다는 의미(Extremely Ranodmized Trees).
- Random Forest와 비슷함.
- Random Forest의 아이디어를 계승하되, '극도의 무작위성(Extreme Randomness)'을 추가하여 분산을 더욱 감소시키는 전략을 사용
- 핵심철학 : 트리의 분산을 더욱 감소시키기 위해 편향을 소폭 희생(편향-분산 트레이드오프 관계) -> 분산은 감소, 편향은 증가
- 그럼 어디에 랜덤성을 기여했다는 거지?
- 핵심 차이점 1. 데이터 샘플링 방식
- Random Forest는 bootstrap(랜덤복원추출)을 쓰는데, Extra Trees는 전체 데이터셋을 그대로 사용(랜덤성이 줄어듬)
- Random Forest는 트리 간의 다양성을 높여 분산 감소에 기여했는데, Extra Trees는 원본 샘플 전체를 사용하여 모델의 편향을 최소화함.
- 핵심 차이점 1. 데이터 샘플링 방식
-
- 핵심 차이점 2. 노드 분할 방식 (여기서 랜덤성을 극도로 했음)
- Random Forest는 최적의 분할 지점을 탐색하기 때문에 연산 비용이 높음 (편향은 낮추고 분산은 높이고)
- Extra Trees는 무작위 분할 지점을 사용함. (편향은 높지만 분산은 낮추고) -> 속도가 Random Forest 보단 빠름
- 핵심 차이점 2. 노드 분할 방식 (여기서 랜덤성을 극도로 했음)
< Ada Boosting >
- 부스팅 : 앙상블 기법의 한 종류 (이전 학습기의 오류를 보완하는 방향으로 다음 학기를 순차적으로 학습)
- AdaBoost의 핵심은, '적응형' 가중치
< Gradient Boosting >
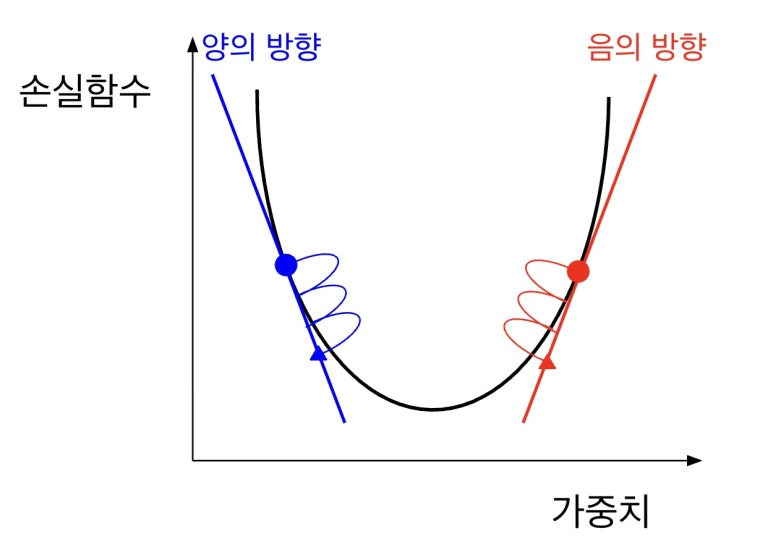
- 손실함수로 미분하면 미분값이 기울기이고 그 기울기가 Gradient 임. Gradient가 '0'이 아니면 learning rate(학습률) 만큼 이동해서 가중치 업데이트 -> 손실함수 -> 기울기 (반복)
-
- Gradient 가 음수면 양의 방향으로 이동
- Gradient가 양수면 음의 방향으로 이동
- 경사하강법(Gradient Descent)을 이용해서 Gradient Boosting이 만들어짐.
- Gradient Boosting Machine(GBM)은 과적합 위험 -> 트리 복잡도 제어와 무작위 샘플링을 통해 안정성 확보
- dropout 기법 - overfitting 방지 기법(딥러닝에서 사용되는 기법) : 전체 인공망 신경 구조를 그대로 쓰는 것이 아니라 특정 노드들을 랜덤하게 비활성화 시킴 -> 가중치 숫자가 줄어듬 (학습 1) 또 특정 노드들을 랜덤하게 비활성화 시킴 -> 가중치 숫자가 줄어듬 (학습 2) --> 계속 반복하면.. 매번 다른 구조의 서브 모델을 학습시키는 효과가 생겨 자연스러운 앙상블 기법이 적용됨. overfitting 방지 기법!!
< XGBoost >
- 뛰어난 예측 성능 : Gradient Boosting 모델 기반
- 빠른 수행 속도 : CatBoost 보단 빠르지만 나머지 모델들 보단 느림, 일부 병렬 처리 지원
- 과적합 방지 : L1, L2(Ridge, Lasso)
- 다양한 편의 기능
- Cross-Validation
- Missing values 자체 처리
- 조기중단(Early Stopping) 기능 : 반복학습을 시키면 처음엔 성능이 확 좋아지는데, 어느 순간 성능이 하락하거나 정체되면 이 구간에서 과감하게 학습을 중단하는 것!