카테고리 없음
머신러닝 2일차
write31991
2026. 8. 28. 16:33
- Target : 해답, 정답에 해당하는 것
- 데이터 분할(층화추출)
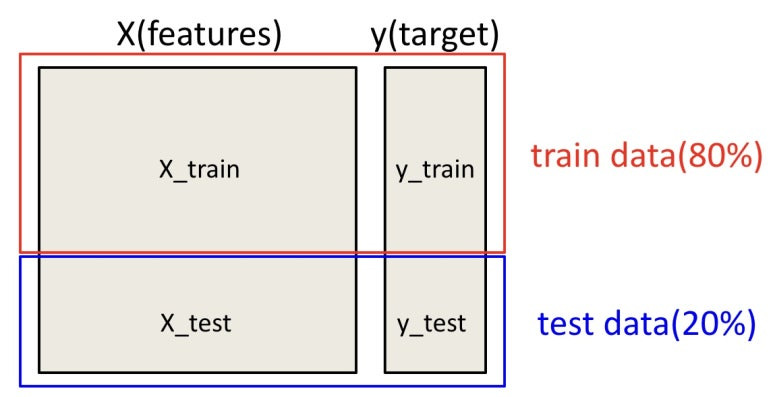
- Leakage(누수, 유출) : train data와 test data 분할 후 섞이지 않도록 잘 관리해야함.
- 분류 / 회귀 (target을 기준으로)
- 분류 : 범주를 맞추는 모델(어느 범주에 속하는지 / target이 범주형일 때)
- 회귀 : 수치를 맞추는 모델(target이 수치형일 때)
- 학습 유형 - 기계 학습
- 지도 학습 : 정답(label, target, 해답, 종속변수)이 있는 데이터 학습; 숫자 맞추기, 범주 맞추기
- 비지도 학습 : 정답이 없는 상태에서 데이터 구조 학습; 군집화, 이상치 탐지, 차원 축소
- 준지도 학습 : 일부 정답이 있는 데이터
- 강화 학습
- 지도 학습이 하고 싶은데, target이 없다면...?
- 직접 target을 지정해야 함(사람이 직접 지정, crowd sourcing, outsourcing, LLM)
- scikit-Learn(sklearn) : 파이썬 기반의 오픈 소스 머신러닝 라이브러리
- 모델 학습 데이터 함수 : fit() / 파라미터에는 X_train, y_train
- 모델 학습이 끝난 후, 평가하는 함수 : predict() / 파라미터에는 X_test
- 다양한 데이터로 변환할 때 쓰는 함수 : transform()
- 파라미터 : 학습시켜야 할 대상(매개변수)
- 하이퍼 파라미터 : 모델의 성능에 직접적인 영향을 주는 파라미터
새로운 개념을 배우는 중.. 복습 필수!